27Bが6.7GBになった — Bonsai 2 27Bを無料Colabで動かし、Q4_K_Mと殴り合わせた
PrismMLが2026年9月17日に公開した Bonsai 2 27B は、Qwen3.8-27B をternaryまで潰したものだ。FP16なら54GB、Q4_K_Mでも16.8GB。それが 6.7GB。無料ColabのT4(15GB)に全層載る。
載った。128Kコンテキストまで張れた。
そこまでは前半の話だ。後半では、同じベースのQ4_K_M版と、同じエージェントタスクで殴り合わせる。ベンチマーク平均98.2%という公称が、誤りが連鎖する多段タスクで何を意味するのかを、8ゲーム・50万トークンずつの実測で確かめた。
先に結論を言うと、「6分の1に劣化」ではなかったし、「ほぼ同等」でもなかった。
TL;DR
| 項目 | 実測値 |
|---|---|
| モデルサイズ | 6.70 GiB(7,206,168,928 バイト。公称5.9GB) |
ロード後VRAM (-c 32768) |
8,619 MiB / 15,360 MiB |
| decode (tg128) | 17.0 tok/s |
| prefill (pp512) | 324.4 tok/s |
| 実用コンテキスト上限 | 131,072(公称262K) |
| ビルド時間(Colab 2コア) | 3,403秒 = 57分 |
| ビルド済みバイナリ配置 | 104秒 |
- 無料T4で27B級が17 tok/s、128Kコンテキスト。 Qwen3-32B Q4はT4×1でOOMなので、載ること自体が新しい
- 警戒していた地雷3つは全部不発。 素のllama.cppは無言で壊れず明確に拒否、repack segfaultは再現せず、
-c 0は仕様通りの挙動 - 本当の敵はビルド時間とセッション消失。 Colabでビルドしてはいけない
- T4は3080の1/3.4の速度。帯域比(2.4倍)以上に開く。ternaryカーネルはAmpere以降に有利
エージェントとしての実力(後半)
同じ Qwen3.8-27B ベースの Q4_K_M と、ARC-AGI-3 の duck ハーネスで 8 ゲーム対決:
| Bonsai PQ2_0 (1.72bpw) | qwen3.8 Q4_K_M (4.8bpw) | |
|---|---|---|
| 合計レベル | 4 | 7 / 6 |
| 8ゲーム中の互角 | 5本 | — |
| 手数 | 439 | 284 / 263 |
| 1レベルあたりの手数 | 110手 | 42手 |
| トークン | 518,628 | 510,640 / 515,945 |
| VRAM | 9.4 GB | 22.1 GB |
| 動くGPU | RTX 3080 (10GB) | 3090 (24GB) |
| 無料Colab T4 | 動く | 載らない |
- 8ゲーム中5本で互角。 差は ft09 と re86 の2本から出ている
- 1レベル取るのに2.6倍の手数。 失われているのは知識量ではなく判断精度
- 下位GPUで1スロットあたり1.36倍速い(32.0 vs 23.5 tok/s)
計測環境: Google Colab 無料枠 / Tesla T4 15,360 MiB (sm75) / 2 vCPU / RAM 12GB / CUDA 12.8 (driver 580.82.07) / PrismML-Eng/llama.cpp prism commit 9a9394a / llama-bench pp512・tg128 各3回平均
そもそも何が起きたのか
Bonsai 2 は Qwen3.8-27B を ternary(真の平均 1.72 bpw、group-128)に潰したものだ。llama.cpp は
アーキテクチャを qwen35 27B PQ2_0 - 2.13 bpw (group 128) と報告する。
パラメータ数は 26.90B のまま。減っているのは1パラメータあたりのビット数だけだ。 FP16 の 16bit が 2.13bit になったので、54GB が 6.7GB になった。
| model                                   |    size |  params | backend | ngl | fa |  test |        t/s |
| qwen35 27B PQ2_0 - 2.13 bpw (group 128) | 6.70 GiB| 26.90 B | CUDA    |  99 |  1 | pp512 | 324.40±2.04|
| qwen35 27B PQ2_0 - 2.13 bpw (group 128) | 6.70 GiB| 26.90 B | CUDA    |  99 |  1 | tg128 |  17.01±0.24|
不発だった地雷① 「素のllama.cppは黙って文字化けを吐く」
PrismMLの公式ドキュメントには、stock build ではこれらのファイルが拒否されること、そして Q2_0 として読まれた場合は無言でロードされて壊れた出力を出す、という趣旨の記述がある。
エラーにならずに壊れるのが一番タチが悪い。ベンチを回してから気づいたら1時間が消える。だから最初に対照実験をやることにした。上流の llama.cpp をビルドして、PQ2_0 を食わせる。
結果:
gguf_init_from_reader: tensor 'output.weight' has invalid ggml type 142. should be in [0, 43)
gguf_init_from_reader: failed to read tensor info
llama_model_load: error loading model: llama_model_loader: failed to load model
明確に拒否された。 ggml type 142 が PQ2_0(forkのgroup-128形式)で、上流が知っている型は0〜42なので範囲外として弾かれる。型番号まで出してくれる、かなり親切なエラーだ。
現行の上流(commit 60081bb, 2026-09-18)では「無言で壊れる」は起きなかった。ドキュメントの記述は古いか、別の条件の話だと思われる。
この確認に57分かかった
問題は結論ではなく、そこに至るコストだった。
>>> STOCK BUILD 3403s rc=0
57分。 Colab無料枠は2コアしかない。CUDAのコンパイルがひたすら遅い。 「とりあえず試す」の代償が1時間で、得られた結論は「動かない」だけだった。
無料枠の実測スペック:
| 値 | |
|---|---|
| GPU | Tesla T4 15,360 MiB(llama.cppからは14,912 MiB) |
| CPU | 2 コア |
| RAM | 12 GB |
| ディスク | 236GB中189GB空き |
| CUDA | 12.8(driver 580.82.07) |
| モデルDL (6.7 GiB) | 53〜63秒 |
ダウンロードは速い。遅いのはCPUだけだ。
不発だった地雷② --no-repack を付けないとsegfaultする
Issue #180 にこうある ——
PQ2_0 をロードすると、64ブロックのrepackが全部成功した後、語彙サイズの output.weight
を処理するところで segfault する。-ngl 99 の全GPUオフロードでも起きる。
回避策は --no-repack または LLAMA_ARG_REPACK=0。
付けずに実行してみた:
> hi
[Start thinking]
The user said "hi" - a simple greeting. I should respond warmly and
[ Prompt: 63.7 t/s | Generation: 16.8 t/s ]
落ちない。 repack有効のまま普通に動いた。--no-repack ありと比べても出力・速度に差はない
(ロード時間は34秒 → 6秒と短縮されたが、これは2回目でページキャッシュに載っていたため)。
commit 9a9394a では修正済みか、CUDA経路では踏まないらしい。issueはVulkanでの報告だった。
不発だった地雷③ -c 0 が通らない
公式ドキュメントには、コンテキストサイズを明示せよ・-c 0 は使うな、という趣旨の記述がある。
262Kコンテキストに釣られて -c 0(モデルの最大値を使う)とやると通らない、と。
やってみた:
ggml_backend_cuda_buffer_type_alloc_buffer: allocating 16384.00 MiB on device 0: cudaMalloc failed: out of memory
alloc_tensor_range: failed to allocate CUDA0 buffer of size 17179869184
llama_init_from_model: failed to initialize the context: failed to allocate buffer for kv cache
これはバグではない。 -c 0 は宣言通りモデル最大(262,144)を取りに行き、そのKVキャッシュが
16 GiB 必要で、T4の15GBに入らないだけだ。仕様通りに動いている。
-c 32768 と書けば動く。「地雷」というより、262Kという数字を額面通り受け取るなという話だった。
本当の地雷 ―― 誰も警告していなかった方
① セッションが落ちると全部消える
Actionsのビルドを待つ間、Colabを1時間ほど触らずにいた。戻ったらこうなった:
[colab] Session 'bonsai' appears to be lost (404/401). Cleaning up.
57分かけた上流ビルドと、6.7GBのモデルが両方消えた。 VMごと回収されている。 無料枠で「後で続きをやる」は成立しない。
② 327MBはColabにアップロードできない
ビルド済みバイナリをColabに送ろうとしたら弾かれた:
[colab] Upload failed: 400 Client Error: Bad Request
Colab CLI の colab upload は Jupyter の contents API を使っていて、大きいファイルが通らない。
327MBは無理だった。
③ -no-cnv は上流から消えている
対照実験のコマンドが最初にこれで弾かれた:
error: invalid argument: -no-cnv
上流 commit 60081bb で削除され、-st, --single-turn に変わっている。
古い記事やドキュメントをコピペすると最初の1回を無駄にする。
④ Colab CLI 自体が壊れている
uv tool install google-colab-cli した直後に:
AttributeError: module 'jupyter_kernel_client' has no attribute 'KernelClient'
依存の jupyter-kernel-client が 1.0.0 で KernelClient → JupyterKernelClient にリネームされたのに、
colab-cli 側はバージョン無指定で依存していて旧名を参照している。
uv tool install --force google-colab-cli --with "jupyter-kernel-client==0.15.0"
あと colab auth はセッションが無いと使えない。先に colab new を実行するとOAuthが始まる。
結論: Colabでビルドしてはいけない
2コアで57分。しかもセッションが落ちれば消える。ビルドは外に出すのが正解だった。
GPUを持たないGitHub Actionsのランナーで焼ける。nvccはコード生成にGPUを必要とせず、 リンクもtoolkit同梱のスタブで足りる。GPUが要るのは実行時だけだ。
この理屈は元々、Kaggleの無料GPU枠がビルドで溶けるのを止めるために使っていた。 そのために作った CLI がそのまま使える:
https://github.com/s-saga011/KaggleCli
gh workflow run build-llamacpp.yml -R s-saga011/KaggleCli \
  -f repo=PrismML-Eng/llama.cpp -f ref=prism \
  -f archs="75;86" -f cuda=12-8 -f shared=OFF \
  -f targets="llama-bench llama-cli llama-server llama-mtmd-cli"
repo / ref を指定できるので、上流だけでなく PrismML fork も同じ導線で焼ける
(PQ2_0 は上流未マージなので、fork でないと読めない)。
成果物には BUILDINFO.txt が同梱され、どのリポジトリのどのコミットを焼いたか後から判別できる。
archs に 75(T4)と 86(3080/3090)を両方入れておけば、1本のバイナリを
Colab にも手元の GPU 機にも Kaggle にも配れる。
ブラウザだけで完結させる
gh コマンドを書いたが、ローカルマシンは要らない。
workflow_dispatch なので、GitHub の Actions タブから Run workflow を押せば
入力がそのままフォームになる。GPUも開発環境も不要で、ブラウザだけで焼ける。
ただし受け取りに一段ある。Artifact は public リポジトリでも API に認証が要る(実測 HTTP 401)。 Colab のセルから直接は落とせない。
そこで release 入力にタグ名を入れると Release asset として公開するようにした。
Release は認証不要なので、こうなる:
# Colab のセル。gh も認証も要らない
!wget -q https://github.com/<you>/KaggleCli/releases/download/llamacpp-sm75-86/llamacpp-bin.tar.gz
!mkdir -p bin && tar xzf llamacpp-bin.tar.gz -C bin && chmod +x bin/llama-*
fork して Actions タブでボタンを押し、Colab で wget する。 これだけだ。 (私が焼いたバイナリは配っていない。自分のリポジトリで焼いてほしい)
| Colab | GitHub Actions | |
|---|---|---|
| コア | 2 | 4 |
| アーキ | sm75のみ | sm75+sm86 fat |
| ターゲット | llama-cli のみ | 4本 |
| リンク | shared (.so同梱) | static 単体 |
| 時間 | 3,403秒 | 3,460秒 |
壁時計はほぼ同じだが、同じ時間で約4倍の成果物が出る。そして本質はそこではない。 焼いたバイナリは Colab・手元のGPU機・Kaggle に同じ1本を配れて、二度と焼かなくていい。
Colabへの配置でもう一段ハマる。327MB は colab upload を通らない
(Jupyter の contents API の上限に当たる)。
GitHub API から署名付きの一時URLを取って、Colab 側に直接 curl させた。
認証情報はローカルから出ない:
curl -s -o /dev/null -D - -H "Authorization: Bearer $(gh auth token)" \
  "https://api.github.com/repos/<owner>/<repo>/actions/artifacts/<id>/zip" \
  | grep -i '^location:'      # → 署名付きURL(認証不要・短命)
>>> FETCH+EXTRACT 104s rc=0
57分が104秒になった。 モデルDLの53秒を足しても、セットアップは157秒で終わる。
速度 ―― T4で27B級は使えるのか
| test | KV | T4 (15GB) | 参考: RTX 3080 (10GB) | 比 |
|---|---|---|---|---|
| pp512 | f16 | 324.4 ± 2.0 | 1,086.9 ± 69.7 | 3.35x |
| tg128 | f16 | 17.0 ± 0.2 | 58.5 ± 0.2 | 3.44x |
| pp4096 | q8_0 | 292.3 ± 2.4 | 1,115.9 ± 0.8 | 3.82x |
| tg128 | q8_0 | 15.9 ± 0.1 | 56.8 ± 0.1 | 3.57x |
前回のKaggle記事と並べる:
| モデル | サイズ | T4×1 |
|---|---|---|
| Qwen3-32B Q4_K_M | 18.6GB | OOM |
| Qwen3.6-27B Q4_K_M | 16.8GB | OOM |
| Bonsai 2 27B PQ2_0 | 6.70 GiB | 17.0 tok/s |
1枚のT4で27B級が動く。これ自体が今までなかった。
T4が不利な理由
T4の帯域は320 GB/s、3080は760 GB/s。帯域比は2.4倍なのに、実測では 3.4倍 開いている。
decodeは通常メモリ帯域律速なので、帯域比通りなら24 tok/s前後が出るはずだった。 1.4倍ぶん余計に遅いのは、ternaryカーネルが演算側でも仕事をしているからだと思われる。 sm75(Turing)はsm86(Ampere)より整数演算まわりが弱い。
前回P100で「Q4カーネルとdp4a命令の相性」を掘ったのと同じ構図で、 極端な低ビット量子化ほど、新しいアーキテクチャでないと旨味が出ない。
コンテキスト ―― 262Kは張れるのか
-fa on -ctk q8_0 -ctv q8_0 でllama-serverを実際に起動して確かめた。
| ctx | T4 (15GB) | 参考: 3080 (10GB, デスクトップが約2GB占有) |
|---|---|---|
| 8,192 | OK — 7,695 MiB | OK — 9,262 MiB |
| 16,384 | OK — 7,995 MiB | OK — 9,343 MiB |
| 32,768 | OK — 8,619 MiB | OK — 9,491 MiB |
| 65,536 | OK — 9,867 MiB | FAIL(compute pp buffers) |
| 131,072 | OK — 12,363 MiB | — |
| 262,144 | FAIL | — |
無料T4で128Kが張れる。 8K→128Kでの増分は4,668 MiB、1Kトークンあたり約39 MiBだ。 27Bのモデルとしては異常に安い。
これは Bonsai 2 のベースがハイブリッドattention(およそ75%がlinear attention、25%がfull attention) だからで、公称262Kが誇張でないことの裏づけになっている。262Kが落ちるのは、 その16 GiBのKVがT4に入らないという物量の問題にすぎない。
面白いのは3080側で、詰まるのがKVではなかったこと。8K→32Kで+229 MiBしか増えないのに
65Kで落ちる。落ちるのはcomputeバッファの確保で、-ub 256 -b 512 まで絞っても通らなかった。
10GBのカードでは、KVより先に別の場所で頭打ちになる。
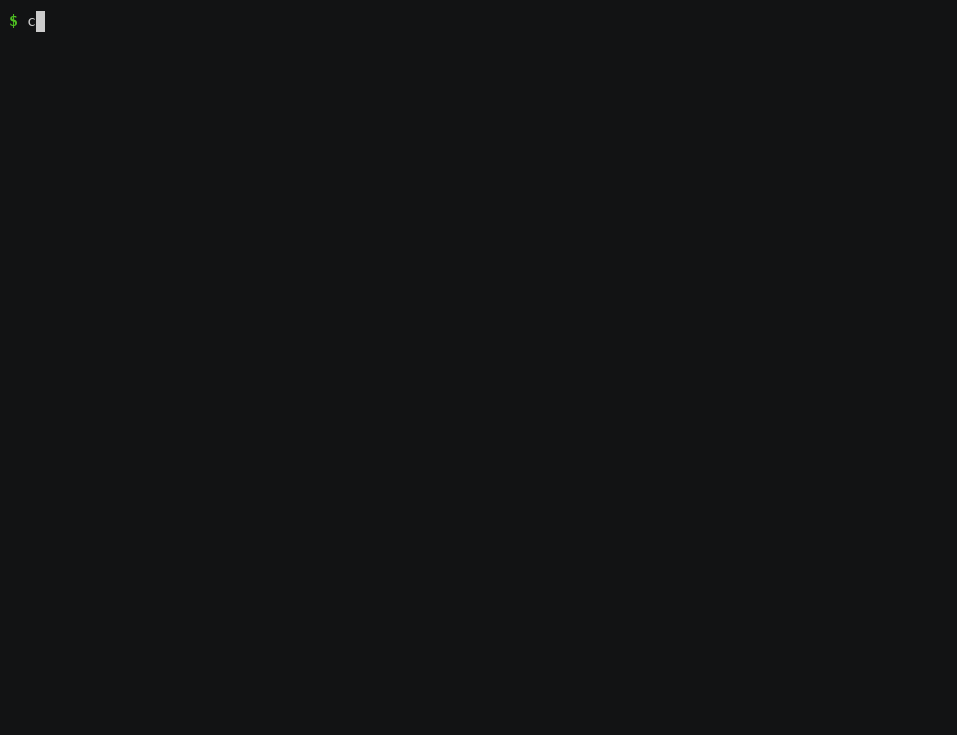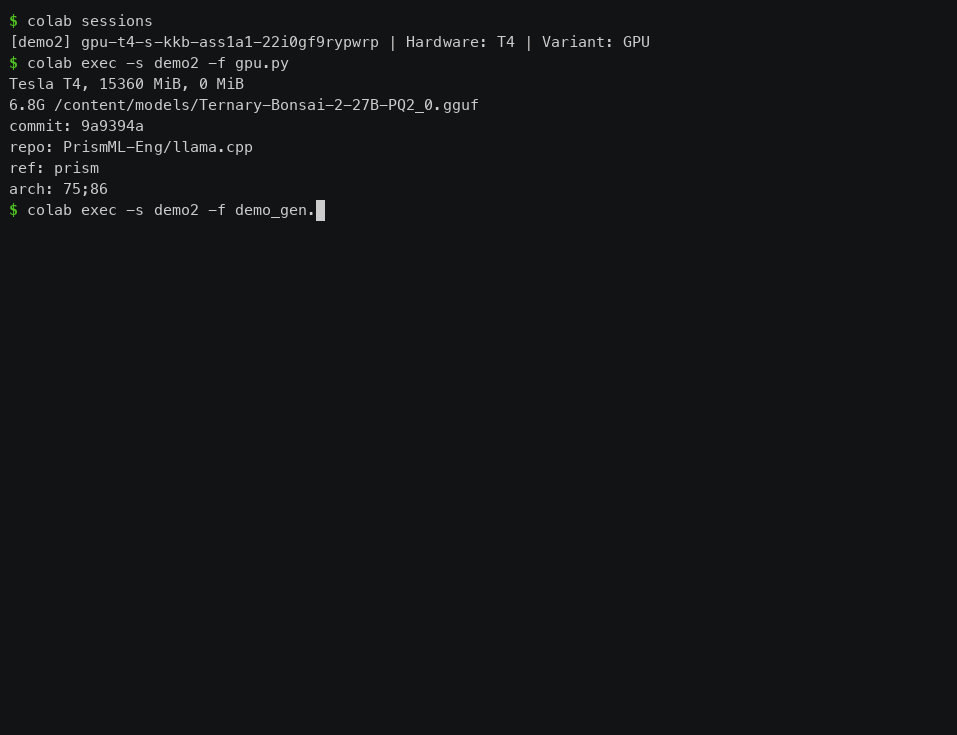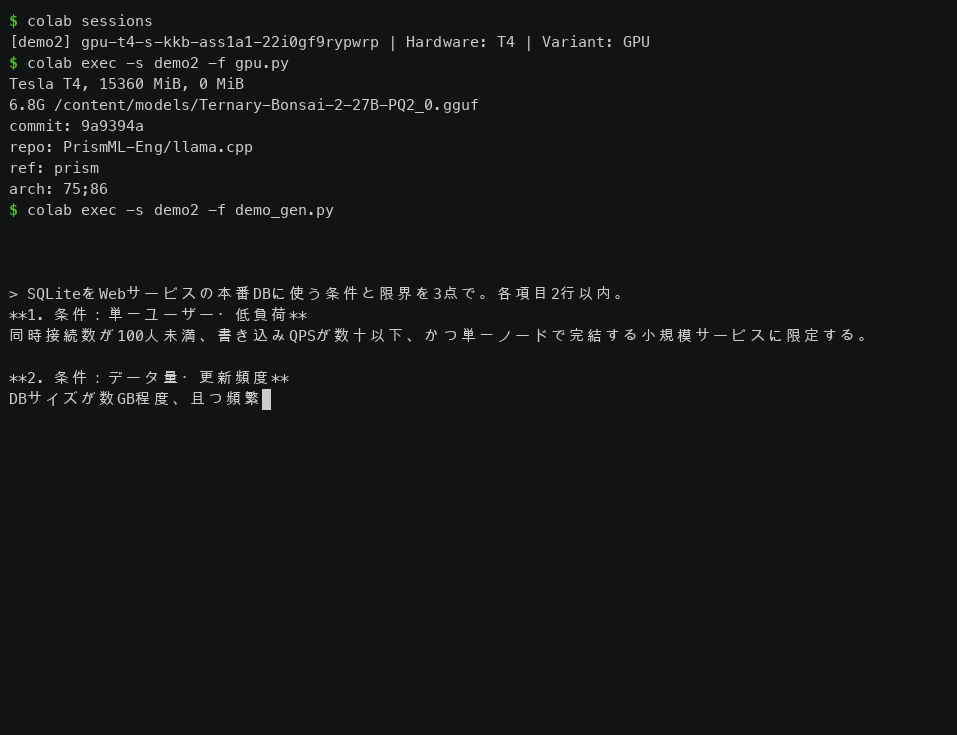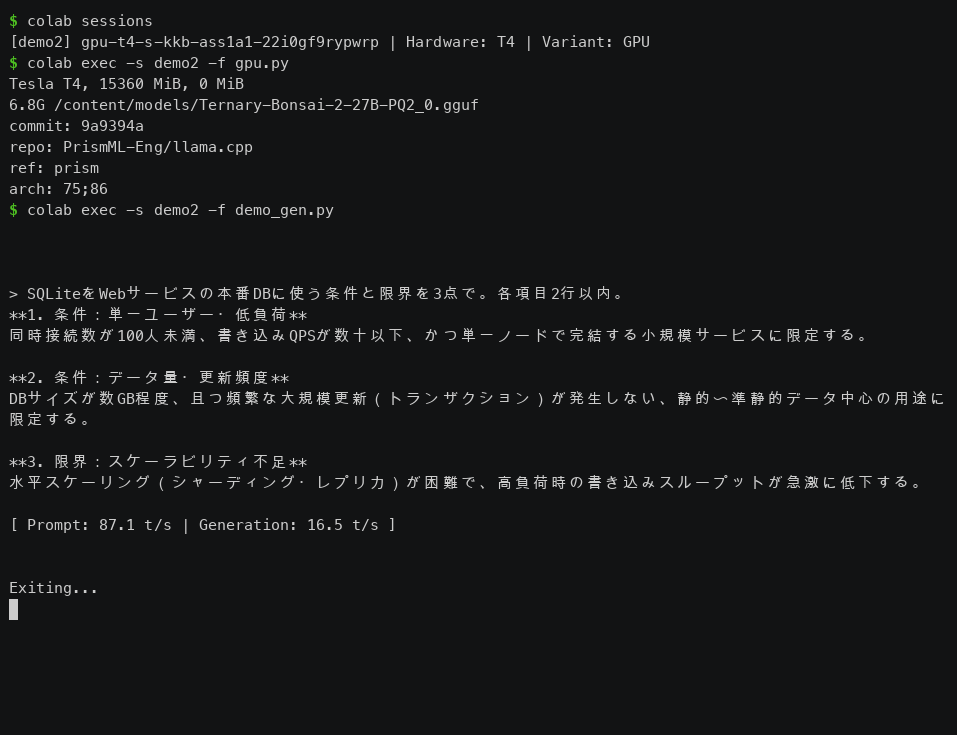
出力の質 ―― 単発ではまったく破綻しない
1. 影響範囲と復旧経緯(開始・復旧時刻、影響対象、ユーザー影響)
2. 検知と初期対応の経緯(アラート、エスカレーション、判断、対応者)
3. 原因特定の現状と未確認事項(AWSインシデント ID、ログ・メトリクス、仮説)
4. 再発防止アクション(監視・冗長性・ランブック改善、責任者・期限)
1.72bpwまで潰したモデルの出力とは思えない。日本語の実務的な問いに対しては、 具体性も正確さも十分にある。
ただしthinkingは英語で出る。これは前回Qwen3を比較したときと同じ挙動で、ベースの性質を引き継いでいる。
問題は、単発の応答で測っても何も分からないということだ。 だから多段タスクで測った。
後半: エージェントとして使えるのか
土俵 ―― ARC-AGI-3 の duck ハーネス
ARC-AGI-3 はグリッドパズルを操作して解くベンチマークだ。モデルは盤面を見て、 Pythonでパーサを書き、次の一手を決め、結果を見て世界モデルを更新する。これを何十手も繰り返す。
1問1答ではなく、誤りが次の手に伝播する。ここが perplexity や MMLU と決定的に違う。
対戦相手は 同じ Qwen3.8-27B の Q4_K_M 版。ベースが同一なので、違うのは量子化だけだ
(llama.cpp はどちらも qwen35 27B / 27.3B params と報告する)。
揃えたもの、揃わなかったもの
最初の測定では Bonsai が 6 分の 1 の成績を出した。それは測り方が間違っていた。 Bonsai 側に不利な条件が 4 つ重なっていた:
- 対照が古いハーネスで取られていた。 同じ qwen3.8 を現行ハーネスで回すと 15/12/14 → 7/6 に落ちる
- sandbox helpers が qwen 側だけ有効だった。 盤面パーサを事前に与える補助輪
- トークン予算が 64% しかなかった
- GPU も並列度も違った
潰した。トークン予算は 518,628 対 510,640 / 515,945 で 101%。 ほぼ完全に揃った。
揃わなかったものは正直に書く: Bonsai 側は n=1(qwen は n=2)、並列度 1 vs 2、 GPU 3080 vs 3090、ランタイムは prism fork vs 上流 b10883、そして qwen 側だけ投機デコードが効いている。
結果 ―― 8ゲーム中5本で互角
| ゲーム | Bonsai PQ2_0 | qwen Q4_K_M (2回) | |
|---|---|---|---|
| ar25 | 1 | 1 / 1 | 互角 |
| ka59 | 0 | 0 / 0 | 互角 |
| sb26 | 1 | 1 / 1 | 互角 |
| tu93 | 1 | 1 / 0 | 互角以上 |
| vc33 | 1 | 1 / 1 | 互角 |
| lf52 | 0 | 1 / 0 | 分け |
| ft09 | 0 | 1 / 2 | 負け |
| re86 | 0 | 1 / 1 | 負け |
| 合計 | 4 | 7 / 6 |
合計の差 2.5 レベルは、実質 ft09 と re86 の 2 本から出ている。 「全面的に劣る」ではなく「特定の場面で崩れる」が正確だ。
何が劣化しているのか ―― 1レベルあたり2.6倍の手数
| 手数 | 合計レベル | 1レベルあたり | |
|---|---|---|---|
| Bonsai | 439 | 4 | 110手 |
| qwen | 274 | 6.5 | 42手 |
Bonsaiは1.6倍多く動いて、レベルは6割。
補助輪(sandbox helpers)を与えると合計レベルは 2 → 4 に倍増した。 パーサを自作する負担が消えて、実際に盤面を操作する回数が増えたからだ。 道具を与えれば「動ける」ようにはなる。
しかし qwen の 6.5 には届かない。「正しい手を選ぶ精度」は道具では埋まらない。
ternary 化で失われているのは知識量ではなく判断精度だ、というのが実測から言えることだ。 1手あたり 98% 正しくても、30手連鎖すれば 0.98^30 ≈ 55%。 ベンチマーク平均 98.2% という公称と矛盾はしない。矛盾しないまま、手数として累積する。
Bonsaiが明確に勝っている点
ここを書かないとフェアではない。
| Bonsai PQ2_0 | qwen3.8 Q4_K_M | |
|---|---|---|
| VRAM | 9.4 GB | 22.1 GB |
| 動くGPU | RTX 3080 (10GB) | 3090 (24GB) が要る |
| 無料Colab T4 (15GB) | 動く。128Kコンテキスト | 16.8GBで載らない |
| 1スロットあたり速度 | 32.0 tok/s(3080) | 23.5 tok/s(3090、47.0÷2) |
| ダウンロード | 6.7GB / 53秒 | 16.8GB |
下位のGPUで1.36倍速い。 そして決定的なのは、無料Colabでは qwen3.8 Q4_K_M は起動すらできないことだ。
「同じ土俵で6割」ではない。「相手が立てない土俵で6割出す」である。
まとめ
前半 ―― 無料Colabで27B級を動かす
- 動く。17.0 tok/s、128Kコンテキスト。Qwen3-32B Q4 は T4×1 でOOMだった領域
- 予習した地雷3つは全部不発。 公式ドキュメントとissueの記述は現行ビルドで再現しなかった
- 本当のコストはビルド時間とセッション消失。 2コアで57分、放置すると消える
- ビルドはActionsに出す。 57分 → 104秒
後半 ―― Q4_K_Mと殴り合わせる
- 8ゲーム中5本で互角。 差は2本から出ている
- 1レベルに2.6倍の手数。 失われるのは知識量ではなく判断精度
- 補助輪を与えれば動けるようになる(合計レベル 2 → 4)が、選択の質は埋まらない
- VRAMは半分以下、下位GPUで1.36倍速い。そもそも相手は無料Colabに載らない
この記事の限界
- 後半の Bonsai 側は n=1(qwen は n=2)。合計レベル 4 のばらつきは測れていない
- 並列度 1 vs 2 / GPU 3080 vs 3090 / ランタイム prism fork vs 上流 b10883
- qwen 側のみ投機デコードが有効
- ハーネスは
ANALYZER_TIMEOUTを上限としつつ残り時間から実効値を縮める(実測 5〜421秒)。 遅いモデルほど終盤で不利になる非対称が残る
最初の測定では「6分の1」という数字が出た。それは測り方が間違っていただけで、 条件を揃えたら 4 対 6.5 になった。この記事で一番時間を使ったのは、Bonsaiを動かすことではなく、 自分の測定が間違っていることに気づくことだった。
で、使えるのか
10GBのGPUしか持っていないなら、選択肢はBonsai 2しかない。 qwen3.8 Q4_K_M は載らない。 その前提で「Q4_K_Mの6割の到達度」なら、十分すぎる。
24GBあるなら Q4_K_M を使うべきだ。 同じトークン予算で1.6倍先に進む。
ternary量子化は「劣化版」ではなく、動かせる場所を増やす技術だと考えた方が実態に合う。